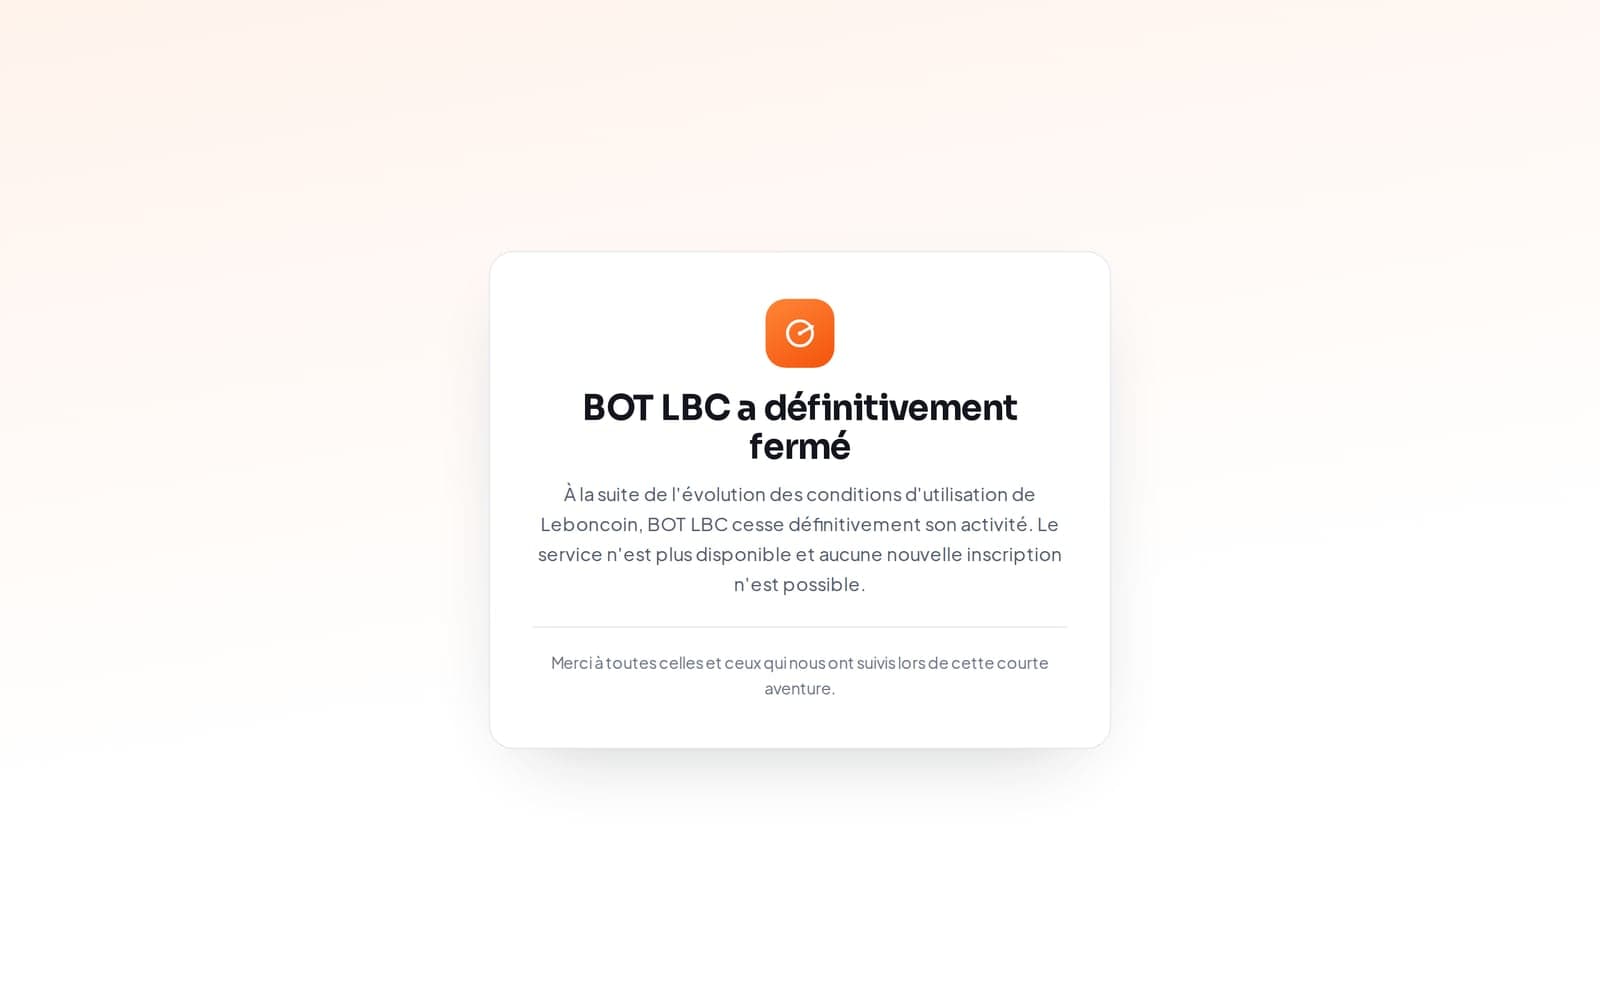
« À la suite de l'évolution des conditions d'utilisation de Leboncoin, BOT LBC cesse définitivement son activité. » Depuis le 21 septembre 2026, c'est le message que l'on trouve sur le site de BOT LBC, quelle que soit la page demandée. Ce robot de veille d'annonces aura vécu quelques mois, et sa fermeture pose une question que se posent beaucoup de développeurs, de fondateurs et de revendeurs outillés : le scraping est-il légal en France ?
La réponse tient en une phrase, mais cette phrase a cinq étages. Aucun texte n'interdit le scraping en tant que tel. Ce sont les données collectées, la manière de les obtenir et l'usage qu'on en fait qui le rendent licite ou non. Nous passons chaque étage en revue, décisions de justice à l'appui, avant de confronter le cas BOT LBC aux textes et de détailler ce qui reste permis.
Un mot de transparence avant d'aller plus loin : Hyrulea et BOT LBC appartiennent au même éditeur. Nous avons donc pu lire le code du service, ce qui nous permet d'en parler précisément, y compris de ce qui n'allait pas. Cet article n'est pas une consultation juridique : il expose les textes et les décisions publiées, avec leurs sources, en l'état du droit au 24 septembre 2026.
BOT LBC : un outil de veille, une fermeture, un cas d'école
BOT LBC était un service français payant, à 29 ou 49 € par mois, destiné aux revendeurs d'occasion. L'abonné enregistrait des « veilles » : mots-clés, catégorie, fourchette de prix, région. Un robot interrogeait ensuite les pages de résultats publiques de la plateforme, relevait les nouvelles annonces (titre, prix, ville, date, vignette, lien) et les rangeait dans l'espace de l'abonné. Chaque annonce recevait une estimation de valeur, calculée à partir des prix demandés sur des annonces comparables, puis un score d'« affaire ».
D'après son code et ses conditions générales, le service ne se connectait à aucun compte, n'achetait rien et n'envoyait aucun message à la place de l'utilisateur. Il alertait, et renvoyait vers l'annonce d'origine. Il se présentait comme indépendant et non affilié à Leboncoin, dont la marque appartient à un tiers.
Ses contenus publics sont datés de fin mai à début septembre 2026. Le 21 septembre, un dernier déploiement a remplacé toutes les pages du site, dont les 43 de son plan de site, par le message de fermeture, et demandé aux moteurs de recherche de ne plus les indexer.
Pourquoi en faire un cas d'école ? Parce que le service avait publié une page « Conformité et cadre légal de la collecte » abondamment sourcée, qui invoquait exactement les textes passés en revue ici : droit des bases de données, arrêts Innoweb et Ryanair de la Cour de justice de l'Union européenne, RGPD, code pénal, parasitisme, Data Act. Et parce que son code montre ce qu'une telle page ne dit pas toujours.
Le message de fermeture ne précise ni quelle clause des conditions de Leboncoin a changé, ni à quelle date, et nous n'irons pas plus loin que ce qu'il dit. Le mécanisme, lui, est limpide : un service construit sur les données d'une plateforme qui ne l'a pas autorisé dépend entièrement de ses règles. Quand elles changent, il n'a aucun contrat sur lequel s'appuyer.
Le scraping est-il légal en France ? La réponse en un tableau
Le scraping, que la CNIL appelle « moissonnage », consiste à faire parcourir des pages web par un programme qui en extrait et en stocke le contenu. Qu'il vise des annonces, des profils ou des prix, cinq corps de règles s'y appliquent en même temps, et chacun protège quelque chose de différent.
| Régime et texte de référence | Ce qu'il protège | Qui peut agir |
|---|---|---|
| Bases de données, droit dit sui generis (CPI, art. L341-1 et suivants) | L'investissement de celui qui a constitué la base | L'éditeur de la base, au civil et au pénal |
| Contrat (CGU, arrêt Ryanair de la CJUE) | Ce que l'éditeur interdit à ses utilisateurs | L'éditeur du site |
| Données personnelles (RGPD, loi Informatique et libertés) | Les personnes citées dans les annonces | La CNIL, les personnes concernées |
| Atteintes aux systèmes informatiques (code pénal, art. 323-1 et suivants) | L'accès au système et son bon fonctionnement | Le parquet, sur plainte ou d'office |
| Concurrence déloyale et parasitisme (code civil, art. 1240) | Les efforts et investissements d'un concurrent | Le concurrent lésé |
S'y ajoute le droit d'auteur dès que l'on republie des photos ou des descriptions : lorsqu'elles sont originales, elles sont protégées au profit de ceux qui les ont prises ou rédigées.
200 000 €
Dommages et intérêts dus par Jinka à Leboncoin
240 000 €
Amende de la CNIL contre KASPR pour aspiration de données
300 000 €
Amende maximale, avec 3 ans de prison, pour atteinte à une base de données
100 000 €
Amende maximale, avec 3 ans de prison, pour accès ou maintien frauduleux
20 M€
Plafond des amendes RGPD, ou 4 % du chiffre d'affaires mondial
15 ans
Durée du droit du producteur, relancée à chaque nouvel investissement substantiel
Pour savoir où se situe un projet, trois questions suffisent à dégrossir :
- Quoi ? Des données personnelles ? Une part importante d'une base qui a coûté cher à constituer ?
- Comment ? Avec un compte, donc des CGU acceptées ? En franchissant un blocage ou un CAPTCHA ? À quel rythme ?
- Pour quoi faire ? Consulter pour soi, faire de la recherche, republier, vendre un service concurrent ?
Plus les réponses penchent vers « beaucoup », « en contournant » et « pour vendre », plus le risque s'accumule sur plusieurs régimes à la fois.
Six idées reçues à oublier
| Idée reçue | Ce que disent les textes |
|---|---|
| « C'est public, donc c'est libre. » | Une page accessible sans mot de passe n'est pas libre de droits. La base d'annonces peut être protégée (CPI, art. L341-1) et les annonces contiennent des données personnelles. |
| « C'est pour mon usage personnel. » | Seule l'extraction d'une partie non substantielle est garantie. L'exception « à des fins privées » pour une partie substantielle ne vise que les bases non électroniques (art. L342-3). |
| « Je ne prends qu'un peu à la fois. » | L'extraction répétée et systématique de petites parties peut être interdite (art. L342-2). |
| « Je n'ai accepté aucune CGU. » | Leur force contractuelle se discute, mais la CNIL les traite comme un signal d'opposition, et elles expriment la volonté de l'éditeur. |
| « Je renvoie vers l'annonce, je suis couvert. » | C'est un argument utile (arrêt CV-Online, jugement DirectAnnonces), pas une immunité : il ne règle ni la question du RGPD ni celle de l'extraction répétée. |
| « Le Data Act autorise le scraping. » | Il vise les données des objets connectés et des services liés. Il ne donne aucun droit de collecter les annonces d'un site web. |
Droit des bases de données : ce que Leboncoin a déjà fait juger
C'est l'arme principale des sites d'annonces, et celle qui explique la plupart des condamnations.
Qui est protégé
L'article L341-1 du code de la propriété intellectuelle, qui transpose la directive 96/9/CE, protège le producteur d'une base de données. Il s'agit de la personne qui prend l'initiative et le risque des investissements, dès lors que la constitution, la vérification ou la présentation du contenu atteste d'un « investissement financier, matériel ou humain substantiel ».
La Cour de justice a précisé ce qui compte dans l'arrêt British Horseracing Board du 9 novembre 2004. Seuls sont pris en compte les moyens consacrés à rechercher, vérifier et présenter des éléments existants. L'argent dépensé pour créer les données n'entre pas dans le calcul. Pour un site d'annonces, dont le contenu est écrit par les utilisateurs, l'investissement protégé est donc celui qui sert à attirer les annonces, à les modérer et à les présenter.
La protection dure quinze ans, comptés à partir du 1er janvier qui suit l'achèvement de la base (ou sa première mise à disposition du public). Elle repart pour quinze ans à chaque nouvel investissement substantiel (art. L342-5). Pour une base alimentée en continu, elle ne s'éteint donc pas en pratique.
Ce qui est interdit
Le producteur peut interdire deux choses (art. L342-1) :
- l'extraction, c'est-à-dire le transfert de tout ou partie substantielle du contenu vers un autre support ;
- la réutilisation, c'est-à-dire la mise à disposition du public de tout ou partie substantielle du contenu.
« Substantielle » s'apprécie en quantité (le volume) ou en qualité (l'importance de ce qui est pris). Surtout, l'article L342-2 ferme la porte à la stratégie du « un peu à la fois ». Le producteur peut aussi interdire l'extraction ou la réutilisation répétée et systématique de parties non substantielles, lorsqu'elle excède manifestement les conditions d'utilisation normales de la base. Un robot qui repasse toutes les quelques minutes sur les mêmes pages de résultats est exactement dans ce cas de figure.
En sens inverse, l'article L342-3 garantit à l'utilisateur qui a licitement accès à une base publique le droit d'en extraire ou réutiliser une partie non substantielle. Toute clause contraire est nulle. Consulter des annonces, en noter quelques-unes, comparer des prix pour soi : ce droit-là, aucune plateforme ne peut le retirer.
Ce que la Cour de justice de l'Union européenne a jugé
Deux arrêts encadrent les services qui interrogent la base d'un autre.
- Innoweb, 19 décembre 2013 (C-202/12). Un « métamoteur de recherche dédié » réutilise le contenu d'une base protégée lorsqu'il réunit trois conditions : il offre un formulaire de recherche aux fonctionnalités en substance identiques à celles de la base, il traduit en temps réel les requêtes de ses utilisateurs vers le moteur de cette base, et il présente les résultats sous l'apparence de son propre site.
- CV-Online Latvia, 3 juin 2021 (C-762/19). La Cour a nuancé : l'extraction ou la réutilisation n'est interdite que si elle porte atteinte à l'investissement du producteur, c'est-à-dire si elle compromet la possibilité d'amortir cet investissement par l'exploitation normale de la base. Un moteur d'offres d'emploi qui renvoie vers le site d'origine n'est donc pas condamné d'office : le juge doit mettre en balance l'investissement protégé et la liberté de concurrence et d'information.
Leboncoin devant les tribunaux français
Leboncoin (société LBC France) a construit en quelques années une jurisprudence fournie, dont l'essentiel concerne sa rubrique immobilier.
Entreparticuliers.com. LBC France reprochait à ce site concurrent de collecter chaque jour ses annonces immobilières pour les reprendre. La cour d'appel de Paris, le 2 février 2021, a reconnu LBC France comme producteur de base de données, au vu de dépenses de plusieurs dizaines de millions d'euros en promotion, collecte, stockage et organisation, selon l'analyse publiée par le cabinet CMS. Elle a aussi admis que la rubrique immobilier formait à elle seule une « sous-base » protégée. La Cour de cassation a rejeté le pourvoi d'Entreparticuliers le 5 octobre 2022 (n° 21-16.307), dans un arrêt publié au Bulletin.
Jinka. Depuis son lancement en juin 2020, cette application d'alertes immobilières utilisait des robots pour extraire en masse des annonces de Leboncoin et en reprendre les critères essentiels, malgré plusieurs mises en garde. Le tribunal judiciaire de Nanterre a condamné son éditeur, Babel France, le 31 mai 2024 à 50 000 € de dommages et intérêts, selon le communiqué de Leboncoin. Le 14 avril 2026, la cour d'appel de Versailles a confirmé l'analyse et porté la somme à 200 000 €, plus 53 000 € au titre des frais d'avocat (communiqué de Leboncoin, MySweetimmo). La même application a aussi été condamnée à la demande de l'éditeur de SeLoger, rapporte Immo Matin.
DirectAnnonces : le contre-exemple. Tout ne se gagne pas d'avance. Le 21 février 2025, le tribunal judiciaire de Paris (n° 21/09261) a débouté LBC France de ses demandes contre DirectAnnonces, qui revendait par abonnement des annonces immobilières collectées par logiciel. Le tribunal a pourtant reconnu les investissements de Leboncoin. D'après l'analyse du cabinet JP Karsenty, il a écarté l'atteinte en retenant que le service concurrent structurait autrement l'information et y ajoutait de la valeur : un raisonnement qui rappelle celui de l'arrêt CV-Online. Il s'agit d'une décision de première instance, qui ne fait pas jurisprudence à elle seule.
Les repères clés, tous régimes confondus :
CJUE, British Horseracing Board
Seul compte l'investissement pour obtenir, vérifier ou présenter des données, pas celui pour les créer.
CJUE, Innoweb
Un métamoteur dédié qui interroge en temps réel la base d'autrui la réutilise.
CJUE, Ryanair
Une base qui n'est pas protégée peut être encadrée par contrat.
Cour de cassation, Bluetouff
Rester dans un système en sachant que son maître n'en veut pas est un délit, même sans mot de passe forcé.
CJUE, CV-Online Latvia
L'extraction n'est interdite que si elle menace l'investissement du producteur.
Cour de cassation, Entreparticuliers
Pourvoi rejeté : le statut de producteur de Leboncoin, reconnu en appel pour sa rubrique immobilier, est confirmé.
Tribunal judiciaire de Nanterre, Jinka
50 000 € de dommages et intérêts pour extraction et réutilisation d'annonces.
CNIL, KASPR
240 000 € d'amende pour l'aspiration de coordonnées sur LinkedIn.
Tribunal judiciaire de Paris, DirectAnnonces
Leboncoin débouté, malgré des investissements reconnus.
CNIL, fiche sur le moissonnage
Les signaux d'opposition des sites (CGU, robots.txt, CAPTCHA) doivent être respectés.
Cour d'appel de Versailles, Jinka
200 000 € de dommages et intérêts, plus 53 000 € de frais.
Fermeture de BOT LBC
« À la suite de l'évolution des conditions d'utilisation de Leboncoin ».
Les CGU peuvent-elles interdire le scraping ?
Oui, dans une large mesure. L'arrêt Ryanair du 15 janvier 2015 (C-30/14) l'a admis pour les bases que la directive ne protège pas. Un comparateur de vols reprenait les données du site de la compagnie. La Cour a jugé que, lorsqu'une base n'est protégée ni par le droit d'auteur ni par le droit sui generis, la directive ne s'applique pas : son créateur peut alors en limiter l'usage par contrat, sous réserve du droit national.
La conséquence est contre-intuitive. Une base protégée ne peut pas interdire par contrat l'extraction de parties non substantielles par un utilisateur légitime, puisque la clause contraire est nulle (art. L342-3). Une base non protégée, elle, peut, sous réserve du droit national, en encadrer bien plus largement l'usage par ses CGU. Les petits sites, faute de pouvoir prouver un investissement substantiel, ont donc intérêt à soigner leurs conditions d'utilisation.
Reste la question de l'opposabilité. Des CGU lient ceux qui les ont acceptées, par exemple en créant un compte pour collecter. Pour un simple visiteur qui n'a rien signé, la question est discutée. C'était précisément l'argument de BOT LBC, dont la page de conformité affirmait : « BOT LBC n'ouvre aucun compte et n'accepte aucune condition en votre nom. » Les abonnés y étaient invités à vérifier eux-mêmes ce que permettent les plateformes.
Cet argument a deux faiblesses. D'abord, c'était le robot du service, et non l'abonné, qui consultait le site. Renvoyer vers l'utilisateur la charge de vérifier des conditions que le service lui-même ignorait ne protège guère. Ensuite, même quand elles ne sont pas opposables comme contrat, des CGU qui interdisent la collecte automatisée comptent ailleurs. Elles expriment la volonté de l'éditeur, ce qui peut peser devant le juge pénal, et la CNIL les traite comme un signal d'opposition au regard du RGPD. Une clause que l'on croit pouvoir ignorer au titre du contrat revient donc par deux autres portes.
Scraping et RGPD : une annonce publique n'est pas une donnée libre
Une petite annonce contient presque toujours des données personnelles : pseudonyme du vendeur, ville, parfois un prénom, des photos, un numéro de téléphone. Les collecter, les stocker ou les analyser constitue un traitement au sens du RGPD. Il faut donc une base légale (article 6), informer les personnes (article 14), limiter la collecte au strict nécessaire, fixer une durée de conservation et respecter le droit d'opposition.
La CNIL le répète depuis des années : des données publiquement accessibles ne sont pas pour autant librement réutilisables, et leur réutilisation reste soumise au RGPD. Le fait qu'un vendeur ait publié son annonce sur une plateforme ne signifie pas qu'il accepte de la voir aspirée par un tiers.
Ce que la CNIL attend d'un moissonnage
Le 19 juin 2025, la CNIL a publié une fiche consacrée au moissonnage (web scraping). Elle vise le développement de systèmes d'intelligence artificielle, mais son raisonnement éclaire, selon nous, toute collecte automatisée fondée sur l'« intérêt légitime ». Elle admet cette base légale sous conditions. Il faut définir à l'avance les données collectées, exclure les catégories sensibles, supprimer rapidement ce qui n'est pas utile et tenir compte des attentes raisonnables des personnes. Surtout, il faut respecter les restrictions exprimées par les sites : CGU, robots.txt, CAPTCHA. Ne pas les respecter fait sortir le traitement des attentes raisonnables, donc de l'intérêt légitime.
Le précédent KASPR
La CNIL a sanctionné ce type de pratique. Le 5 décembre 2024, elle a infligé 240 000 € d'amende à la société KASPR. Son extension Chrome payante permettait d'obtenir les coordonnées de personnes dont on visitait le profil LinkedIn, et sa base comptait environ 160 millions de contacts. La CNIL lui a reproché d'avoir collecté les coordonnées d'utilisateurs qui avaient choisi d'en limiter la visibilité, de les conserver cinq ans à compter de chaque mise à jour, et d'avoir mal informé les personnes concernées : pas du tout jusqu'en 2022, puis uniquement en anglais.
La leçon dépasse LinkedIn : une extension ou un robot qui puise dans une plateforme reste un traitement de données dont l'éditeur répond, et les choix de confidentialité exprimés sur la plateforme d'origine s'imposent à lui.
Code pénal : quand le scraping devient un délit
Les articles 323-1 et suivants du code pénal, issus de la loi Godfrain de 1988, répriment les atteintes aux « systèmes de traitement automatisé de données ». Depuis la loi d'orientation du ministère de l'Intérieur du 24 janvier 2023, l'accès ou le maintien frauduleux dans un tel système est puni de trois ans d'emprisonnement et 100 000 € d'amende (art. 323-1). Extraire, reproduire ou transmettre frauduleusement les données qu'il contient est puni de cinq ans et 150 000 € (art. 323-3). Entraver ou fausser son fonctionnement, par exemple en le surchargeant de requêtes, est réprimé par l'article 323-2.
Consulter une page publique n'a rien de frauduleux. Mais « sans mot de passe » ne veut pas dire « sans risque ». La Cour de cassation l'a montré dans l'affaire dite Bluetouff (chambre criminelle, 20 mai 2015, n° 14-81.336). Un internaute avait trouvé, grâce à un moteur de recherche, des documents d'un extranet de l'Anses normalement protégé par une authentification. Il les avait téléchargés et en avait publié une partie. Il a été relaxé pour l'accès, mais condamné à 3 000 € d'amende pour maintien frauduleux et vol de données : une fois sur place, il savait que le maître du système ne voulait pas de lui.
Qu'en est-il des protections anti-robot, du blocage d'adresse IP ou du CAPTCHA ? À notre connaissance, aucune décision française publiée n'a tranché le cas précis du contournement d'une protection anti-robot sur des pages publiques. Le raisonnement de l'affaire Bluetouff s'y transpose pourtant sans difficulté. Une protection anti-robot exprime sans ambiguïté la volonté de l'éditeur. La franchir sciemment, c'est accumuler les risques : pénal, contractuel et RGPD en même temps.
Parasitisme, Data Act, DSA, IA : les autres textes en jeu
Concurrence déloyale et parasitisme
Même sans droit sur la base, un éditeur peut agir sur le fondement de l'article 1240 du code civil : « Tout fait quelconque de l'homme, qui cause à autrui un dommage, oblige celui par la faute duquel il est arrivé à le réparer. » Les tribunaux en ont tiré la notion de parasitisme : se placer dans le sillage d'un autre pour profiter de ses efforts et de ses investissements sans bourse délier. Cet argument est souvent soulevé à côté du droit des bases de données, ou à sa place quand celui-ci fait défaut.
Deux éléments pèsent en défense. Le service renvoie-t-il vers la source, ou la remplace-t-il ? Apporte-t-il une valeur propre, ou revend-il simplement le travail d'autrui ? C'est sur ce terrain que la page de BOT LBC était la plus solide : chaque alerte renvoyait vers l'annonce d'origine, et l'estimation de prix était calculée par le service lui-même.
Data Act : pas un droit de scraper
Le règlement (UE) 2023/2854 sur les données, applicable depuis le 12 septembre 2025, est souvent cité à tort dans ce débat. Il organise notamment l'accès aux données générées par les objets connectés et les services liés, le partage de ces données et le changement de fournisseur de cloud. Son article 43 écarte le droit sui generis pour ces seules données. Il ne donne aucun droit de collecter les annonces d'un site web.
DSA : un accès réservé aux chercheurs
Le règlement sur les services numériques (DSA) oblige, dans son article 40, les très grandes plateformes à donner aux chercheurs qui remplissent certaines conditions un accès à leurs données publiquement accessibles. Le 5 décembre 2025, la Commission a d'ailleurs infligé 120 millions d'euros d'amende à X, notamment pour ne pas avoir respecté cet accès. Ce droit reste toutefois réservé à la recherche sur les risques systémiques des plus grandes plateformes. Il ne profite ni à un revendeur ni à une start-up.
IA et fouille de textes et de données
Depuis l'ordonnance du 24 novembre 2021, qui achève la transposition de la directive (UE) 2019/790, le code de la propriété intellectuelle autorise la fouille de textes et de données. Il s'agit de l'analyse automatisée de contenus auxquels on a licitement accès, pour en tirer des tendances ou des corrélations. Cette exception s'étend aux bases de données (art. L342-3). Hors recherche scientifique, elle cède devant l'opposition du titulaire, exprimée notamment, pour les contenus en ligne, par des procédés lisibles par machine.
Le règlement européen sur l'IA impose depuis le 2 août 2025 aux fournisseurs de modèles d'IA à usage général de se doter d'une politique pour respecter ces oppositions (les modèles mis sur le marché avant cette date ont jusqu'au 2 août 2027). Nous faisons le point sur ce qui s'applique cette année dans notre article sur l'AI Act. Attention au contresens : cette exception couvre l'analyse de contenus. Elle n'autorise ni à republier des annonces ni à vendre un service d'alertes.
Ce qui pourrait changer
La Commission a proposé fin 2025 un paquet de simplification, le « Digital Omnibus », qui retoucherait notamment le RGPD. En septembre 2026, son volet données est toujours en discussion au Conseil, et le Parlement n'a pas arrêté sa position. Rien de ce qui précède n'a changé à ce jour.
Le cas BOT LBC passé au crible
Reprenons les principaux arguments de la page « Conformité » de BOT LBC et confrontons-les aux textes, aux décisions et au code que nous avons pu lire.
| Ce qu'affirmait la page | Ce que disent les textes et les juges | Notre lecture |
|---|---|---|
| Requêtes « ciblées sur les critères d'un abonné », volume plafonné : pas d'extraction substantielle | L'art. L342-2 vise aussi l'extraction répétée et systématique de parties non substantielles ; Leboncoin a fait protéger à part sa rubrique immobilier, comme « sous-base » | Fragile. Des veilles permanentes, cumulées sur tous les abonnés, ressemblent à une extraction répétée et systématique. |
| Pas de moteur de recherche public, mais la veille privée d'un abonné identifié (Innoweb) | Innoweb : formulaire équivalent, requêtes relayées en temps réel, résultats dans sa propre interface ; CV-Online exige en plus une atteinte à l'investissement | Discutable. Le fonctionnement réel se rapproche des trois critères d'Innoweb. Le renvoi vers l'annonce d'origine joue en sa faveur au regard de CV-Online. |
| Aucun compte ouvert, aucune CGU acceptée : aux abonnés de vérifier | Ryanair : l'éditeur d'une base non protégée peut en encadrer l'usage par contrat ; la CNIL traite les CGU contraires comme un signal d'opposition | Fragile, puis intenable quand les conditions ont évolué : c'est le motif avancé pour la fermeture. |
| Intérêt légitime, minimisation, information générale (art. 6.1.f et 14.5.b du RGPD) | CNIL, 2025 : respecter les signaux d'opposition ; affaire KASPR : l'information des personnes est contrôlée | Bonnes pratiques réelles, mais base légale fragilisée dès que la plateforme s'oppose. |
| « Aucun contournement de CAPTCHA ni de dispositif anti-robot » ; « une passe par heure au maximum » | Code pénal, art. 323-1 et 323-3 ; affaire Bluetouff | Contredit en partie par le code (voir ci-dessous). |
| Chaque alerte renvoie vers la source ; la valeur ajoutée est la nôtre (parasitisme) | Code civil, art. 1240 ; jugement DirectAnnonces de 2025 | L'argument le plus solide de la page. |
Ce que le code ajoute
Deux écarts ressortent entre la page et le code du service.
Le premier porte sur le rythme. La page annonçait « une passe par heure au maximum ». Le code du robot espaçait en réalité ses passes, par défaut, de 13 à 31 minutes, avec une pause nocturne de 2 h à 8 h.
Le second porte sur la détection. La page affirmait : « Aucun contournement de CAPTCHA ni de dispositif anti-robot. » Le code montre une histoire plus compliquée. Les premières requêtes, envoyées depuis un serveur en ligne, étaient refusées dès la première tentative par la protection anti-robot de la plateforme. Le projet a ensuite déplacé la collecte vers d'autres environnements et intégré des mécanismes destinés à rendre le robot moins détectable. Nous n'en détaillerons pas le fonctionnement. Il est exact, en revanche, que le robot s'arrêtait lorsqu'un contrôle anti-robot se déclenchait, avec une mise en quarantaine de plus en plus longue avant toute nouvelle tentative.
Deux points jouent en faveur du service, et il est juste de les relever. Il avait retiré de sa page d'accueil une promesse d'« achat automatique », que ses auteurs jugeaient eux-mêmes trompeuse au regard du code de la consommation, puisqu'il n'achetait rien. Et il a fermé quand les conditions de la plateforme ont changé, plutôt que de s'entêter. D'autres ont payé ce choix devant les tribunaux : Jinka avait poursuivi son activité malgré plusieurs mises en garde.
Ce qui reste permis : les alternatives légales au scraping
Tout ce qui précède ne condamne pas la veille d'annonces. Cela condamne la collecte automatisée sans accord. Pour chaque besoin courant, une voie sans risque juridique existe.
| Votre besoin | La voie légale | Sa limite |
|---|---|---|
| Être prévenu des nouvelles annonces | Les recherches sauvegardées et les alertes proposées par la plateforme elle-même, dont Leboncoin | Pas d'alerte « sous la cote » : l'estimation reste, en général, à faire soi-même |
| Connaître le juste prix d'un objet d'occasion | Un relevé manuel de quelques annonces comparables, puis leur médiane | Ce sont des prix demandés, pas des prix de vente |
| Connaître les prix immobiliers réels | Les Demandes de valeurs foncières (DVF), publiées en open data par la DGFiP | Transactions passées, publiées avec un décalage |
| Intégrer des données dans un produit | Une API officielle, une licence ou un partenariat, par écrit | Conditions, quotas et coût fixés par le détenteur des données |
| Données publiques et administratives | data.gouv.fr et les API de l'État sur api.gouv.fr | Licences à respecter, dont la mention de la source |
| Étudier un marché à des fins de recherche | L'exception de fouille de textes et de données ; l'article 40 du DSA pour les très grandes plateformes | Réservé à des cadres précis |
Savoir ce que vaut un objet est souvent la vraie motivation d'un robot. Or la méthode manuelle fonctionne. On relève une dizaine d'annonces du même modèle, on écarte les lots et les accessoires, on prend la médiane et on garde à l'esprit qu'un prix affiché n'est pas un prix de vente. Nous l'appliquons aux consoles dans notre guide pour estimer le prix d'une PS5 ou d'une Switch 2 d'occasion et aux composants dans notre article sur l'achat d'un PC gamer ou d'une carte graphique d'occasion.
Pour les revendeurs, le site Zoukayzie, qui appartient au même éditeur qu'Hyrulea, propose un guide gratuit de l'achat-revente qui recommande les recherches sauvegardées de la plateforme. Il y explique comment établir soi-même une cote à partir de la médiane d'annonces comparables. Le guide évoque aussi l'ancien robot de veille de son auteur, devenu BOT LBC et aujourd'hui fermé, et avance des fourchettes de gains qui relèvent de l'expérience déclarée de l'auteur, pas d'une promesse.
Une dernière précaution s'impose. Répondre vite à une alerte expose aussi aux escrocs, qui publient de fausses « bonnes affaires » pour piéger les acheteurs pressés. Les techniques de cette année sont détaillées dans notre article sur les arnaques sur Leboncoin, Vinted et Marketplace.
Entrepreneurs : les leçons d'une fermeture
Le parcours de BOT LBC est celui de beaucoup de projets nés d'une bonne intuition commerciale : un besoin réel, une solution technique qui marche, et une fondation juridique qui ne dépend pas de vous. Voici la démarche que nous recommandons avant d'écrire la première ligne de code.
Identifier à qui appartiennent les données
Base de données protégée, données personnelles, contenus sous droit d'auteur : dressez la liste des droits en jeu et des personnes qui peuvent les faire valoir. Un site d'annonces qui a déjà plaidé est un signal clair.
Lire les conditions, et les relire
CGU, robots.txt, pages destinées aux développeurs. Elles évoluent : selon son annonce, BOT LBC a fermé à la suite d'une telle évolution. Prévoyez une veille sur ces documents et datez vos lectures.
Demander avant de prendre
API officielle, licence, partenariat : une demande écrite, même refusée, vaut mieux qu'une collecte non autorisée. Un refus vous renseigne aussi sur le modèle économique de la plateforme, et donc sur la viabilité du vôtre.
Faire l'analyse RGPD d'emblée
Base légale, information des personnes, minimisation, durée de conservation, droit d'opposition. Si la source s'oppose à la collecte, l'intérêt légitime ne tient plus.
Aligner le discours sur le code
Une page de conformité ou un argumentaire commercial qui dit autre chose que le code est une pièce à charge en cas de litige, et une pratique commerciale potentiellement trompeuse. Chaque affirmation doit être vraie dans le code, pas seulement souhaitable.
Prévoir la sortie
Que deviennent vos abonnés, leurs données et leurs paiements si la plateforme dit non demain ? Un service qui ne peut pas répondre à cette question n'a pas de plan B.
Nous revenons sur la trajectoire économique du service, de l'idée à la fermeture, dans notre autopsie d'un SaaS bâti sur la plateforme d'un autre. Si vous revendez vous-même de l'occasion de façon régulière, la question suivante est fiscale et sociale : notre guide de la micro-entreprise en 2026 fait le point.
Les signaux qui doivent vous arrêter
- La plateforme vous bloque, vous limite ou vous présente un CAPTCHA
- Les CGU interdisent l'extraction automatisée, ou viennent de changer
- Votre produit reproduit l'essentiel des annonces plutôt que d'y renvoyer
- Vous collectez des téléphones, des e-mails ou des photos de personnes
- La matière première de ce que vous vendez est la base de données d'un autre
- Votre page de conformité dit autre chose que votre code
La fermeture de BOT LBC n'a rien d'un scandale. Elle montre simplement ce qui arrive à un service dont la matière première appartient à quelqu'un d'autre. En France, la question n'est pas de savoir si le scraping est « autorisé » dans l'absolu, mais si le détenteur des données, les personnes concernées et la loi vous laissent faire ce que vous comptez faire. Tant que la réponse n'est pas clairement oui, la voie la plus sûre reste de consulter à la main, d'utiliser les outils de la plateforme ou de négocier un accès.
Vous travaillez sur un projet qui dépend des données d'un tiers, ou vous avez une question sur ce cas ? La communauté h/tech en discute, et les revendeurs échangent leurs méthodes manuelles dans h/achatrevente.